
Was KI wirklich kostet: Tokens, Kontext und versteckte Kosten
„Wird ChatGPT mich in einem Jahr ersetzen?“ Mit dieser Frage hat Tom Haberland, Jazzgitarrenlehrer und YouTuber, Jens, den Inhaber von Selt, für ein Podcast-Gespräch in Berlin besucht. Eine Stunde lang ging es darum, ob KI Musiker und Lehrer ersetzt, was ein Token ist und warum selbstgebaute KI-Tools manchmal nach fünf Minuten den Dienst quittieren.
Das Gespräch dreht sich um Musik, aber die meisten Antworten gelten genauso für Unternehmen. Vor allem eine: Ob KI eine Aufgabe übernehmen kann, ist oft gar nicht die entscheidende Frage. Entscheidend ist, was es kostet.
Was ist ein Token?
Wer mit ChatGPT, Claude oder Gemini arbeitet, zahlt am Ende nicht pro Frage, sondern pro Token. Ein Token ist ein Textbaustein, in den das Modell jede Eingabe und jede Antwort zerlegt. Als Faustregel entspricht ein Token grob einem Wort, bei deutschen Texten mit ihren langen zusammengesetzten Wörtern oft etwas mehr.
Im Abo für 20 € im Monat merkt man davon wenig. Sobald KI aber über eine API in eigene Abläufe eingebunden wird, steht hinter jeder Anfrage ein konkreter Betrag. Abgerechnet wird pro Million Tokens, getrennt nach Eingabe und Ausgabe, und die Preise unterscheiden sich je nach Modell um ein Vielfaches.
Warum jede Nachricht teurer wird als die letzte
Hier liegt der erste Denkfehler. Ein KI-Modell hat kein Gedächtnis für den bisherigen Chatverlauf. Bei jeder neuen Nachricht wird die gesamte Unterhaltung erneut an das Modell geschickt: die erste Frage, die erste Antwort, die zweite Frage und so weiter.
Tom hat das im Podcast treffend zusammengefasst: Es ist, als würde man das komplette Gespräch von vorne beginnen, nur um ein einziges Wort hinzuzufügen. Je länger eine Unterhaltung, desto teurer wird jede weitere Nachricht. Das erklärt auch, warum KI-gestütztes Programmieren so schnell ins Geld geht: Quellcode ist lang, und er wird immer wieder mitgeschickt.
Die versteckten Tokens: Websuche, PDFs, KI-Agenten
Der zweite Kostentreiber ist unsichtbar. Fragt man ein modernes Modell nach den fünf besten Gitarrenlehrern in Berlin, passiert im Hintergrund deutlich mehr als eine Antwort: Das Modell sucht im Netz, ruft die gefundenen Websites auf, liest sie ein und fasst sie zusammen. Jede dieser Seiten landet als Tokens im sogenannten Kontextfenster und damit auf der Rechnung.
Für den Nutzer sieht das aus wie eine ganz normale Frage. Tatsächlich wurden möglicherweise zehntausende Tokens verarbeitet. Dasselbe gilt für hochgeladene PDFs und besonders für KI-Agenten, die selbstständig Werkzeuge nutzen, Dateien durchsuchen und mehrere Schritte hintereinander ausführen. Je mehr Freiheit ein Agent hat, desto schwerer lassen sich die Kosten vorab abschätzen.
Wenn KI teurer wird als ein Mensch
„KI ersetzt Jobs“ ist eine der meistdiskutierten Thesen der letzten Jahre, und in manchen Bereichen stimmt sie auch. Viele Unternehmen haben zum Beispiel weniger Junior-Entwickler eingestellt, weil KI einen großen Teil ihrer Routineaufgaben übernehmen kann.
Im Gespräch kam aber auch die Gegenbewegung zur Sprache, die wir selbst beobachten: Am Ende des Monats kommt eine Rechnung über alle verbrauchten Tokens, und die fällt höher aus als gedacht. Für manche Aufgaben ist ein Mensch unterm Strich günstiger, und oft macht er den Job auch besser. Ob sich KI für eine Aufgabe lohnt, ist also keine Grundsatzfrage, sondern eine Rechnung: wie oft die Aufgabe anfällt, wie viel Kontext sie braucht und was ein Fehler kostet.
Context Engineering: bessere Antworten, weniger Umwege
Die wirksamste Stellschraube für Qualität und Kosten ist der Kontext. Ein Musiklehrer weiß nach einer halben Sekunde, dass vor ihm ein 15-jähriger Anfänger aus Europa sitzt, der noch nie von Tonleitern gehört hat. Ein KI-Modell weiß das nicht. Fragt man es nach „der coolsten Tonleiter“, kann es genauso gut mit orientalischen oder chinesischen Skalen antworten.
Profis nennen das Context Engineering: dem Modell gezielt die Informationen mitzugeben, die es für die Aufgabe braucht. Dazu gehören der Wissensstand, das Ziel und die Form, die das Ergebnis haben soll. Tom macht das im eigenen Unterricht genauso: Vor der ersten Stunde gibt es ein Telefonat, in dem geklärt wird, wo der Schüler steht und was er erreichen will. Und am Ende jedes Prompts steht der Satz: „Wenn etwas unklar ist, frag mich, bevor du anfängst.“
Guter Kontext spart doppelt. Die Antworten passen beim ersten Mal, und es braucht weniger Korrekturschleifen, die jeweils den gesamten Verlauf erneut verarbeiten.
Wann sich KI-Automatisierung rechnet
Im Podcast kamen drei Beispiele zur Sprache, die zeigen, wo die Grenze verläuft.
Rechnet sich: der automatisierte Unterrichtsbericht. Tom unterrichtet über Zoom und hat früher nach jeder Stunde 10 bis 15 Minuten eine Zusammenfassung aus dem Gedächtnis geschrieben. Heute erkennt eine kleine Automation neue Aufzeichnungen, verschiebt sie ins Google Drive und transkribiert sie lokal auf dem Mac. Nur das fertige Transkript geht per API an die KI, die daraus eine Zusammenfassung erstellt. Nach einem kurzen Gegenlesen landet sie per Klick beim Schüler. Die Aufgabe fällt ständig an, der Tokenverbrauch ist überschaubar, und ein Mensch prüft das Ergebnis. So sieht sinnvolle KI-Automatisierung aus.
Rechnet sich eher nicht: der „Tom-Bot“. Toms Idee war, alle Unterrichtsaufzeichnungen in eine KI zu packen, die Schülerfragen im eigenen Stil beantwortet. Technisch machbar, aber die Antworten müssen laufend überprüft werden, das Wissen entwickelt sich weiter und muss nachgepflegt werden, und jede Schülerfrage kostet Tokens, auch die, die nur zum Spaß gestellt werden. Der Aufwand übersteigt schnell den von zehn persönlich beantworteten Fragen.
Ein Prototyp ist kein Produkt: die KI als DJ. Für eine Party hat Jens an einem Nachmittag eine App gebaut, die Claude mit Spotify verbindet und die Playlist per Chat steuert. Zu Hause lief alles. Auf der Party funktionierte sie fünf Minuten, dann griff das Anfragelimit von Spotify und die App war blockiert. Genau das ist der Kern von Vibe Coding, also Software per Prompt zu erzeugen, statt sie selbst zu programmieren: Für einen schnellen Prototyp ist das hervorragend. Für etwas, worauf sich andere verlassen, braucht es jemanden, der Limits, Sicherheit, Wartung und Kosten von Anfang an mitdenkt.
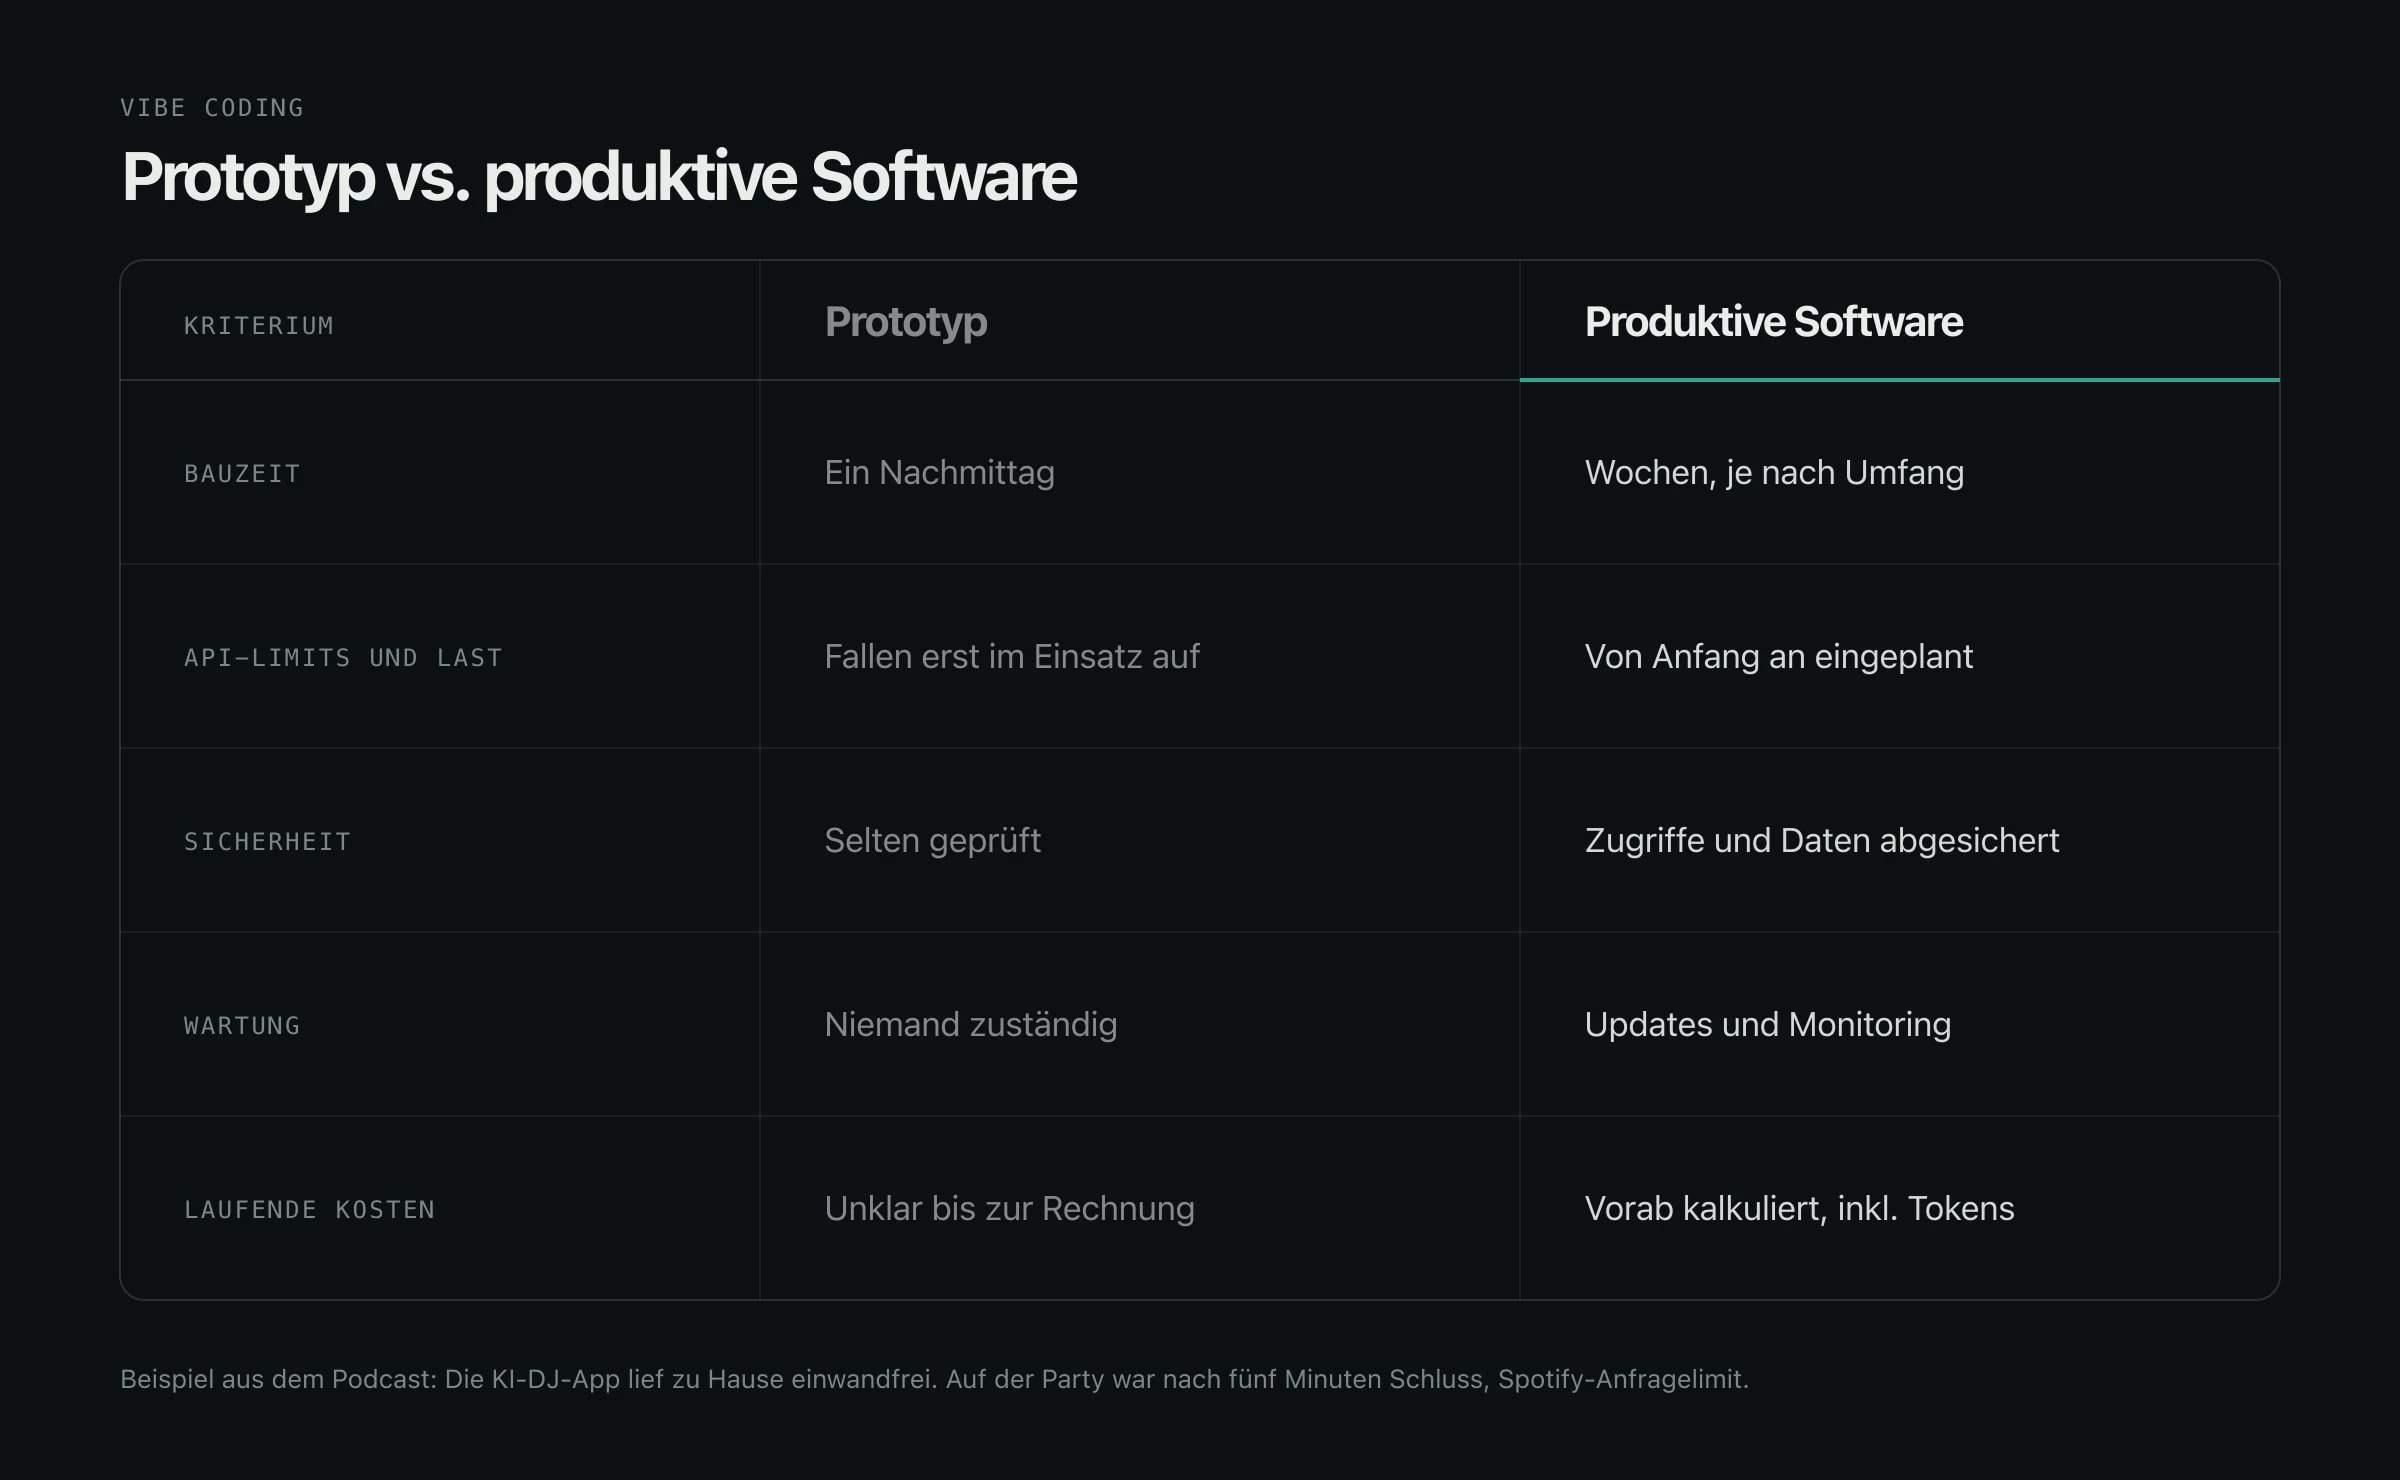
Der Prototyp ist trotzdem wertvoll. Wenn uns ein Kunde eine selbst gebaute Vibe-Coding-Version zeigt, ist das die beste Beschreibung dessen, was gebraucht wird, die wir bekommen können.
Was das für den Mittelstand heißt
Für KI im Mittelstand gilt dasselbe wie für einen Gitarrenlehrer mit Zoom-Kurs: Nicht jede Aufgabe, die KI übernehmen kann, sollte sie auch übernehmen. Die Aufgaben, die sich lohnen, fallen regelmäßig an, brauchen einen klar umrissenen Kontext und haben am Ende einen Menschen, der das Ergebnis kurz prüft. Und die Kosten sollte man kennen, bevor die erste Monatsrechnung kommt, nicht erst danach.
Genau hier setzt unsere KI-Beratung für den Mittelstand an. Wir schauen uns an, welche Abläufe in Ihrem Unternehmen heute Zeit fressen, und rechnen durch, wo sich KI tatsächlich lohnt, inklusive der Tokenkosten im laufenden Betrieb. Daraus bauen wir Lösungen, die nicht nach fünf Minuten an ein Limit stoßen, sondern im Alltag laufen.
Die ganze Folge mit Tom Haberland gibt es oben im Video und auf YouTube. Wer Gitarre lernen will, findet Tom unter tomhaberland.com.
Ein erstes Projekt, das Vertrauen schafft
Es zeigt, was KI in Ihrem Unternehmen schon leisten kann. Die offenen Themen gehen wir danach an, wenn sie Sinn ergeben. Wir versprechen nichts, was wir nicht halten.
Sprechen wir über Ihr Projekt